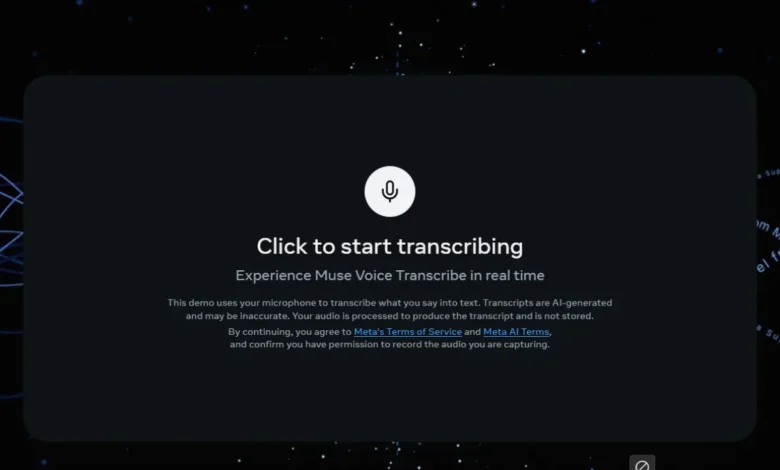

شرکت متا از مدل هوش مصنوعی جدیدی به نام Muse Voice Transcribe رونمایی کرده است؛ مدلی که برای تبدیل لحظهای گفتار به متن طراحی شده و میتواند علاوه بر تشخیص صحبتها، گویندههای مختلف را نیز از یکدیگر تفکیک کند.
این مدل نخستین مدل درک صوتی بلادرنگ متا محسوب میشود و در حال حاضر در قابلیت دیکته صوتی Meta AI برای مک و همچنین Muse Code مورد استفاده قرار گرفته است. توسعهدهندگان نیز میتوانند از طریق Meta Model API به آن دسترسی داشته باشند.
Muse Voice Transcribe چه کاری انجام میدهد؟
تفاوت اصلی مدل جدید متا با بسیاری از سرویسهای سنتی تبدیل گفتار به متن این است که چند قابلیت مختلف را در یک مدل واحد ترکیب میکند.
Muse Voice Transcribe میتواند:
- گفتار را بهصورت بلادرنگ به متن تبدیل کند.
- صدای بیش از ۲۰ گوینده را از یکدیگر تفکیک کند.
- تشخیص دهد چه زمانی گوینده صحبت خود را به پایان رسانده است.
- در یک مکالمه بین زبانهای مختلف جابهجا شود.
- بدون نیاز به مرحله پردازش جداگانه، اطلاعات مربوط به گویندگان را در متن خروجی لحاظ کند.
این قابلیتها باعث میشوند مدل برای جلسهها، مصاحبهها، مکالمات طولانی و ابزارهای دیکته صوتی کاربرد ویژهای داشته باشد.
پشتیبانی از بیش از ۷۰ زبان
یکی از نقاط قوت Muse Voice Transcribe، تمرکز متا بر قابلیتهای چندزبانه است. این مدل با دادههای بیش از ۷۰ زبان آموزش داده شده و در زمان عرضه، عملکرد آن در ۲۵ زبان اعتبارسنجی شده است.
متا همچنین قابلیت Code-Switching را در مدل جدید قرار داده است؛ یعنی کاربر میتواند در جریان یک مکالمه بین زبانهای مختلف جابهجا شود و مدل همچنان فرایند تبدیل گفتار به متن را ادامه دهد.
این ویژگی برای مکالمات چندزبانه اهمیت زیادی دارد؛ زیرا در چنین شرایطی معمولاً سیستمهای سنتی باید زبان ورودی را از قبل مشخص کنند یا در تشخیص تغییر زبان با مشکل مواجه شوند.
تشخیص بیش از ۲۰ گوینده در یک فایل صوتی
Muse Voice Transcribe فقط کلمات گفتهشده را ثبت نمیکند؛ بلکه میتواند تشخیص دهد چه کسی صحبت کرده است.
متا اعلام کرده مدل قادر است در فایلهای صوتی طولانی که بیش از یک ساعت زمان دارند نیز بیش از ۲۰ گوینده را از یکدیگر تفکیک کند.
این قابلیت که با عنوان Speaker Diarization شناخته میشود، برای پیادهسازی خودکار جلسات و مصاحبهها اهمیت زیادی دارد. در روشهای قدیمیتر، تبدیل صدا به متن و تشخیص گوینده معمولاً بهعنوان دو مرحله جداگانه انجام میشد، اما Muse Voice Transcribe این فرایند را در یک مدل ترکیب میکند.
فناوری Adaptive Delay؛ مدل تصمیم میگیرد چه زمانی متن را نمایش دهد
یکی از جالبترین ویژگیهای فنی Muse Voice Transcribe، فناوری Adaptive Delay یا «تأخیر تطبیقی» است.
در سیستمهای تبدیل گفتار به متن، یک مشکل همیشگی وجود دارد: اگر مدل خیلی سریع متن را تولید کند، ممکن است به دلیل نداشتن اطلاعات کافی کلمات را اشتباه تشخیص دهد؛ اگر هم بیش از حد صبر کند، سرعت پاسخگویی کاهش پیدا میکند.
متا برای حل این مشکل، به مدل اجازه داده است برای هر کلمه بهصورت پویا تصمیم بگیرد که آیا اطلاعات صوتی کافی در اختیار دارد یا باید کمی بیشتر گوش کند.
در نتیجه، کلمات ساده میتوانند سریعتر پردازش شوند و برای واژههای دشوارتر، مدل زمان بیشتری برای دریافت اطلاعات صوتی اختصاص میدهد.
پردازش صدا در قطعات ۸۰ میلیثانیهای
Muse Voice Transcribe یک مدل خودبازگشتی و چندوجهی از خانواده Muse Spark است.
سیستم صدای ورودی را در قطعات ۸۰ میلیثانیهای پردازش میکند. پس از دریافت هر قطعه، مدل تصمیم میگیرد که اطلاعات کافی برای تولید یک توکن متنی را دارد یا باید برای دریافت بخش بعدی صدا منتظر بماند.
این معماری به مدل اجازه میدهد سرعت و دقت را بهصورت همزمان مدیریت کند؛ موضوعی که برای سرویسهای تبدیل گفتار به متن بلادرنگ اهمیت حیاتی دارد.
متا میگوید Muse Voice Transcribe در صدر یک بنچمارک قرار دارد
متا اعلام کرده است که Muse Voice Transcribe در تاریخ ۱ سپتامبر ۲۰۲۶ در رتبه نخست جدول رتبهبندی تبدیل گفتار به متن بلادرنگ Artificial Analysis قرار داشته است.
بر اساس دادههای منتشرشده درباره عملکرد مدل، Muse Voice Transcribe در آزمایشهای انگلیسی به نرخ خطای کلمهای (WER) حدود ۳.۱ درصد دست یافته و زمان رسیدن به متن نهایی پس از پایان صحبت حدود ۰.۱۶ ثانیه گزارش شده است. البته این اعداد به شرایط و مجموعهداده آزمایش وابستهاند و نباید آنها را معادل عملکرد قطعی مدل در تمام زبانها و محیطها دانست.
Muse Voice Transcribe در مک چگونه استفاده میشود؟
این فناوری همین حالا در Meta AI برای مک مورد استفاده قرار گرفته است.
کاربر میتواند در هر برنامهای که امکان ورود متن دارد، کلید Fn را نگه دارد و صحبت کند تا Muse Voice Transcribe گفتار را به متن تبدیل کند.
این قابلیت میتواند استفاده از دیکته صوتی را برای نوشتن ایمیل، پیام، یادداشت و سایر متنها سادهتر کند.
دسترسی توسعهدهندگان به مدل جدید متا
Muse Voice Transcribe فقط برای محصولات خود متا ساخته نشده است. این مدل از طریق Meta Model API نیز در اختیار توسعهدهندگان قرار گرفته است.
متا قیمت استفاده از API را ۳ دلار به ازای هر هزار دقیقه صوت اعلام کرده که معادل حدود ۰.۱۸ دلار برای هر ساعت صوت است.
این مدل میتواند برای ساخت ابزارهایی مانند موارد زیر مورد استفاده قرار گیرد:
- پیادهسازی خودکار جلسات و مصاحبهها
- زیرنویس زنده
- یادداشتبرداری صوتی
- دستیارهای صوتی
- تحلیل تماسهای صوتی
- ابزارهای تولید محتوا
- نرمافزارهای چندزبانه
Muse Voice Transcribe چه تفاوتی با تبدیل گفتار به متن معمولی دارد؟
مدلهای معمول Speech-to-Text عمدتاً وظیفه تبدیل صدا به کلمات را انجام میدهند. اما Muse Voice Transcribe تلاش میکند چند مرحله از فرایند درک صوتی را در یک مدل واحد ادغام کند.
| قابلیت | Muse Voice Transcribe |
|---|---|
| تبدیل گفتار به متن | دارد |
| پردازش بلادرنگ | دارد |
| تشخیص گوینده | دارد |
| تشخیص بیش از ۲۰ گوینده | دارد |
| پشتیبانی چندزبانه | بیش از ۷۰ زبان آموزشی |
| Code-Switching | دارد |
| تشخیص پایان صحبت | دارد |
| Adaptive Delay | دارد |
| فایلهای طولانی | بیش از یک ساعت |
| دسترسی API | دارد |
| استفاده در Meta AI مک | دارد |
| کاربرد در Muse Code | دارد |
Muse Voice Transcribe جدیدترین تلاش متا برای ساخت یک لایه درک صوتی بلادرنگ است که میتواند گفتار را هنگام صحبتکردن به متن تبدیل کند و همزمان بیش از ۲۰ گوینده را از یکدیگر تشخیص دهد.
پشتیبانی از بیش از ۷۰ زبان، قابلیت جابهجایی میان زبانها، فناوری Adaptive Delay و امکان استفاده از مدل از طریق API، Muse Voice Transcribe را به رقیبی جدی در حوزه تبدیل گفتار به متن بلادرنگ تبدیل کردهاند. این فناوری هماکنون در Meta AI برای مک و Muse Code استفاده میشود و توسعهدهندگان نیز میتوانند از آن در محصولات خود بهره بگیرند.
منابع
- Digit
- Meta
- 9to5Mac